Opus 5.5 chegou: ganha em sete dos nove testes e custa 60% menos que o Fable 5.1 na saída
A Anthropic publicou a comparação com Fable 5.1, Opus 5 e GPT-6 Astra. O número que decide a sua conta não está na manchete: é o preço da leitura de cache, que caiu para US$ 0,20.

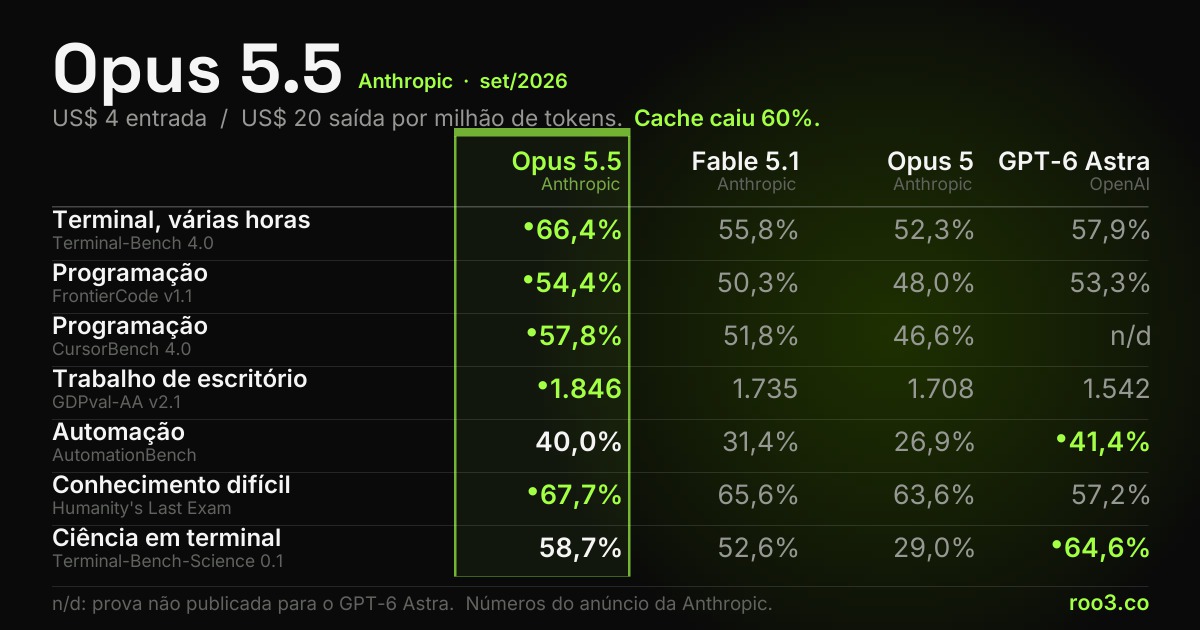
A Anthropic lançou o Claude Opus 5.5 em 22 de setembro de 2026, custando US$ 4 por milhão de tokens de entrada e US$ 20 de saída, 20% abaixo do Opus 5 e 60% abaixo do Fable 5.1. Na comparação publicada pela própria empresa, contra o Fable 5.1, o Opus 5 e o GPT-6 Astra, ele vence em sete dos nove testes, incluindo os três de programação. Perde dois para o GPT-6 Astra: automação e ciência em terminal. O número que a manchete não destaca é a leitura de cache, que caiu de US$ 0,50 para US$ 0,20 por milhão, uma queda de 60% que vale mais que o preço de entrada para quem roda agente ou chat com instrução longa.
O que você leva deste artigo
- O modelo já está no catálogo oficial da Anthropic como claude-opus-5-5.
- Preço: US$ 4 por milhão de entrada e US$ 20 de saída. O Fable 5.1 cobra US$ 10 e US$ 50.
- Leitura de cache caiu de US$ 0,50 para US$ 0,20 por milhão, 60% a menos. É a linha que mais mexe na conta real.
- Vence em 7 dos 9 testes publicados, incluindo os três de programação.
- Perde 2 para o GPT-6 Astra: AutomationBench (40,0% contra 41,4%) e Terminal-Bench-Science (58,7% contra 64,6%).
- Gera texto mais de 30% mais rápido que o Opus 5, e a Anthropic diz que sai 40% mais barato de rodar em carga típica.
- O modo rápido dobra a tabela: US$ 8 de entrada e US$ 40 de saída.
- Sonnet 5.5 e Haiku 5.5 foram prometidos para as próximas semanas.
O que saiu, e como confirmar sem depender de print
O Claude Opus 5.5 saiu em 22 de setembro de 2026, sem as semanas de anúncio adiado que marcaram o lançamento do Grok 4.7. Foi direto da página oficial para o catálogo.
A forma de confirmar continua sendo a mesma de sempre, e não é a captura de tela que circula: o identificador claude-opus-5-5 está na documentação da Anthropic, com preço publicado, e o modelo já aparece na Claude Platform, na AWS, no Google Cloud e no Azure. Print de tabela qualquer um monta.
Junto com o modelo veio a comparação oficial contra o Claude Fable 5.1 e o Claude Opus 5, ambos da casa, e contra o GPT-6 Astra, da OpenAI. É ela que está reproduzida abaixo, com os números conferidos contra o anúncio.
A tabela, com os nove testes e os três preços
Duas leituras antes de olhar. A primeira: os preços do GPT-6 Astra não entraram na tabela da Anthropic, então a coluna dele fica vazia nas linhas de preço. Preferimos a célula vazia ao número chutado.
A segunda: quatro das nove linhas são de programação ou de trabalho autônomo em terminal. Essa é a briga que a Anthropic escolheu comprar, e é onde a diferença aparece maior.
| Opus 5.5 novo | Fable 5.1 | Opus 5 | GPT-6 Astra | |
|---|---|---|---|---|
| Preço de entrada US$ por milhão de tokens | US$ 4 | US$ 10 | US$ 5 | não publicado |
| Preço de saída US$ por milhão de tokens | US$ 20 | US$ 50 | US$ 25 | não publicado |
| Leitura de cache US$ por milhão de tokens | US$ 0,20 | não publicado | US$ 0,50 | não publicado |
| Trabalho de terminal longo Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% |
| Programação FrontierCode v1.1 | 54,4% | 50,3% | 48,0% | 53,3% |
| Programação CursorBench 4.0 | 57,8% | 51,8% | 46,6% | não medido |
| Trabalho de escritório GDPval-AA v2.1 | 1.846 | 1.735 | 1.708 | 1.542 |
| Automação AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% |
| Conhecimento difícil Humanity's Last Exam | 67,7% | 65,6% | 63,6% | 57,2% |
| Ciência em terminal Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% |
| Uso de computador OSWorld 2.0 | 81,8% | 80,7% | 74,0% | não medido |
| Leitura de gráfico Chartography | 89,0% | 88,4% | 83,4% | não medido |
O que inverteu em relação à semana passada
Ontem publicamos aqui a conta do Grok 4.7, e a pergunta que ela deixava era direta: os vinte pontos de diferença no Terminal-Bench valem pagar oito vezes mais na saída? O modelo barato ganhava em dois testes de sete, e o caro ganhava onde o trabalho é longo e autônomo.
O Opus 5.5 mexe nos dois lados dessa conta ao mesmo tempo, e é isso que o torna incomum. Ele subiu no teste em que o caro já ganhava, de 55,8% do Fable para 66,4%, e desceu o preço, de US$ 50 para US$ 20 na saída.
Na prática, a distância entre o topo e o barato encolheu por baixo. O Grok 4.7 continua custando US$ 6 na saída, contra os US$ 20 do Opus 5.5. Ainda são mais de três vezes, mas não são mais as oito vezes de ontem. E do outro lado da mesa, a diferença de capacidade em trabalho de terminal abriu: 38,0% do Grok contra 66,4% do Opus 5.5.
Quem estava adiando a decisão esperando o preço do topo cair tem agora um motivo concreto para refazer a planilha. Quem decidiu pelo barato por causa do custo de saída deveria refazer também, porque o número que sustentava a escolha mudou.
É raro um lançamento mexer nas duas colunas na mesma direção. Normalmente você paga mais pelo melhor, ou aceita menos pelo barato. Aqui o melhor ficou mais barato, e isso reabre decisões que já estavam fechadas.
Onde ele não ganha, e vale dizer com todas as letras
Das nove provas, o GPT-6 Astra vence duas, e a própria Anthropic mostra isso na tabela dela. Registrar isso não é detalhe: é o que separa uma comparação de um anúncio.
No AutomationBench, que mede automação de tarefas, são 41,4% do GPT-6 Astra contra 40,0% do Opus 5.5. A diferença é de 1,4 ponto, dentro do que qualquer variação de medição explicaria. Chamar isso de derrota é quase forçar a barra, mas chamar de vitória do Opus seria mentira.
No Terminal-Bench-Science, que mede trabalho científico dentro do terminal, a diferença é real: 64,6% do GPT-6 Astra contra 58,7% do Opus 5.5. São quase seis pontos, e é a única linha da tabela em que o modelo novo fica claramente atrás de alguém.
Vale olhar essa linha por outro ângulo também. O Opus 5 fazia 29,0% nela. Saltar para 58,7% é dobrar o resultado em uma geração, o maior avanço interno de toda a tabela. O modelo melhorou muito no que era o ponto mais fraco dele, e continua atrás do concorrente. É exatamente o que acontecia com o Grok 4.7 no Terminal-Bench, e a leitura é a mesma: evolução grande não é o mesmo que liderança.
O número que decide a conta não está na manchete
A manchete do lançamento é o preço de entrada e saída. A linha que vai mexer de verdade na sua fatura é outra: a leitura de cache caiu de US$ 0,50 para US$ 0,20 por milhão de tokens, uma queda de 60%.
Cache, aqui, é o pedaço do texto que se repete a cada chamada: a instrução do sistema, o catálogo de produtos, o manual da empresa, o histórico da conversa. Você paga barato para o modelo reler o que já viu, em vez de pagar entrada cheia toda vez.
Em qualquer coisa que rode de verdade, esse pedaço domina a conta. Um chat de atendimento com instrução de 8 mil tokens, respondendo 3 mil conversas no mês com 6 turnos cada, relê aquela instrução 18 mil vezes. São 144 milhões de tokens de cache. A US$ 0,50 isso custava US$ 72. A US$ 0,20 custa US$ 28,80. A conta de entrada e saída nem entrou nesse cálculo.
É por isso que comparar modelo só pelo preço de entrada engana. Dois modelos com a mesma tabela de entrada podem ter faturas muito diferentes dependendo de quanto cobram para reler o que se repete, e quase ninguém olha essa linha antes de decidir.
Preço de manchete é sobre o token novo. Preço real é sobre o token repetido. Em aplicação que roda todo dia, o repetido é a maior parte.
A letra miúda: o modo rápido dobra a tabela
Existe uma linha que não estava na imagem do lançamento e que merece a mesma atenção que os 200 mil tokens do Grok.
O Opus 5.5 tem um modo rápido, e ele tem tabela própria: US$ 8 de entrada e US$ 40 de saída, exatamente o dobro do preço normal. Quem ligar o modo rápido achando que está só ganhando velocidade vai descobrir o preço na fatura, não na hora de decidir.
Dobrado, ele volta a custar quase o que o Fable 5.1 custa em modo normal. Então a pergunta prática é se a velocidade extra vale o dobro. Para um agente que roda sozinho de madrugada, quase certamente não: ninguém está esperando. Para um chat em que a pessoa olha a tela enquanto a resposta sai, talvez sim, porque ali a espera tem custo de abandono.
A Anthropic diz que o modelo já gera texto mais de 30% mais rápido que o Opus 5 no modo normal, e que sai 40% mais barato de rodar em carga típica, contando a economia de passos e não só a tabela. Esse segundo número é o mais difícil de conferir de fora, porque depende do que se chama de carga típica. Trate como estimativa do fabricante, não como medida.
A parte de segurança, e por que ela aparece aqui
A Anthropic destacou que o Opus 5.5 tentou contornar limites cerca de 85% menos que o Opus 5, que tirou as melhores notas da casa numa auditoria automatizada de comportamento, e que está menos propenso a executar ações difíceis de desfazer.
Isso costuma ser lido como assunto de laboratório, e não é. Quem coloca um modelo para mexer sozinho em sistema de produção, apagar registro, enviar e-mail em nome da empresa ou aprovar pagamento, está exposto exatamente a isso. Um modelo que evita ação irreversível quando está em dúvida vale mais, nesse cenário, do que alguns pontos a mais num teste.
A ressalva de sempre: quem mediu foi quem vende. A auditoria é da própria Anthropic, sobre o próprio modelo. O número serve como sinal de direção, não como garantia, e não substitui limitar o que o modelo pode fazer no seu sistema. Permissão apertada continua sendo mais confiável que bom comportamento.
O que muda para quem usa IA no trabalho
Se você usa IA pela interface, num plano mensal, quase nada muda esta semana além de o modelo ficar melhor e mais rápido. Você não escolhe modelo por preço de token.
Se você construiu alguma coisa que chama a API, a tabela tem consequência direta, e ela cabe em cinco decisões.
- Se você trocou o topo por um modelo barato só por causa do custo de saída, refaça a conta: a diferença caiu de oito vezes para pouco mais de três.
- Antes de comparar modelos, some o custo de cache, não só entrada e saída. Em aplicação com instrução longa, o cache costuma ser a maior linha da fatura.
- Se o seu sistema usa modo rápido, confira se ele está ligado de propósito. A tabela dobra, e isso não aparece no painel.
- Para agente que executa sozinho em sistema de verdade, pese a queda de 85% em tentativa de contornar limite junto com os benchmarks. Mas continue apertando as permissões do mesmo jeito.
- Antes de trocar por causa de benchmark, rode as SUAS dez tarefas reais nos dois modelos e compare resultado e custo. Dez pontos num teste padronizado podem virar zero no seu caso, ou o contrário.
O que ainda não dá para dizer
Duas coisas ficam em aberto, e é honesto listá-las em vez de fingir que a tabela resolve tudo.
A primeira: não existe ainda medição independente do Opus 5.5. A Epoch AI, que é a fonte do nosso AI Benchmark, ainda não publicou o ECI dele, e é normal: o modelo saiu hoje. Ele deve aparecer por lá em breve na faixa de recém-lançados, com traço no lugar da nota, que é como o Grok 4.7 apareceu no dia do lançamento dele. Até o ECI sair, tudo o que existe é a tabela do fabricante. Ela não é falsa, mas foi ele quem escolheu quais nove provas mostrar.
A segunda: Sonnet 5.5 e Haiku 5.5 foram prometidos para as próximas semanas. São eles que definem o preço da faixa que a maioria das empresas realmente usa. Se a queda de preço do Opus se repetir nos menores, a conta de quem roda volume muda muito mais do que mudou hoje.
Perguntas frequentes
O Opus 5.5 é melhor que o Fable 5.1 e que o GPT-6?
Na comparação publicada pela Anthropic, o Opus 5.5 vence em sete dos nove testes, incluindo os três de programação e o de trabalho longo em terminal. O GPT-6 Astra vence dois: automação, por 1,4 ponto, e ciência em terminal, por quase seis pontos. O Fable 5.1 não vence nenhum, e custa duas vezes e meia mais na saída.
Quanto custa o Opus 5.5?
US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de saída. A leitura de cache custa US$ 0,20 e a escrita de cache US$ 5 por milhão. O modo rápido dobra entrada e saída, para US$ 8 e US$ 40. Para comparar: o Fable 5.1 cobra US$ 10 e US$ 50, e o Opus 5 cobrava US$ 5 e US$ 25.
Por que o preço do cache importa tanto?
Porque em aplicação que roda de verdade a maior parte dos tokens é repetida: a instrução do sistema, o catálogo, o histórico da conversa. Você paga leitura de cache toda vez que o modelo relê esse pedaço. Num chat com instrução de 8 mil tokens e 18 mil turnos no mês, a queda de US$ 0,50 para US$ 0,20 tira a fatura desse pedaço de US$ 72 para US$ 28,80, sem contar entrada e saída.
Vale trocar o modelo barato pelo Opus 5.5 agora?
Depende do que você roda. Para classificar mensagem, resumir e extrair dado em volume, o barato continua resolvendo e a diferença de qualidade não aparece. Para agente que executa sozinho por horas mexendo em código ou em sistema, a diferença ficou grande e o preço ficou menor, então a conta que dava negativa semana passada pode dar positiva agora. O caminho certo é rodar as suas próprias tarefas nos dois antes de mudar qualquer coisa em produção.
Dá para confiar nesses números?
Como ponto de partida, sim, com a ressalva de sempre: a tabela foi publicada pela Anthropic sobre um modelo da Anthropic, e foi ela quem escolheu quais nove provas mostrar. Vale registrar que a tabela mostra duas derrotas para o GPT-6 Astra, o que é sinal de uma comparação menos maquiada que a média. Medição independente, como a da Epoch AI, ainda não existe para este modelo.
Quando o Opus 5.5 entra no AI Benchmark da ROO3?
Em duas etapas, e nenhuma delas usa número de fabricante. Assim que a Epoch AI registra o modelo no catálogo dela, o cron diário o coloca na faixa de recém-lançados da página, com traço no lugar da nota, porque nota ainda não existe. Quando a Epoch publica o ECI, ele sai da faixa e entra no ranking, na posição que o número der. Aquela página não mede modelo nenhum: ela reúne o ECI da Epoch AI e o ELO da Arena, e é só isso que ela mostra.
O que são Sonnet 5.5 e Haiku 5.5?
São os modelos menores da mesma geração, prometidos pela Anthropic para as próximas semanas. Costumam ser os mais usados em produção, porque resolvem a maior parte das tarefas por uma fração do preço do topo. Se a queda de preço vista no Opus 5.5 se repetir neles, o impacto na conta de quem roda volume será bem maior do que o de hoje.
Rodrigo Fávaro
Fundador da ROO3, agência de marketing e tecnologia em São José do Rio Preto. Constrói produtos com IA em produção (Tobia, gerar.app, Pense Mercado) e mantém o AI Benchmark, ranking público de modelos de IA. Veja a consultoria em IA da ROO3.
X @rodmf LinkedIn rodrigofavaroContinue lendo
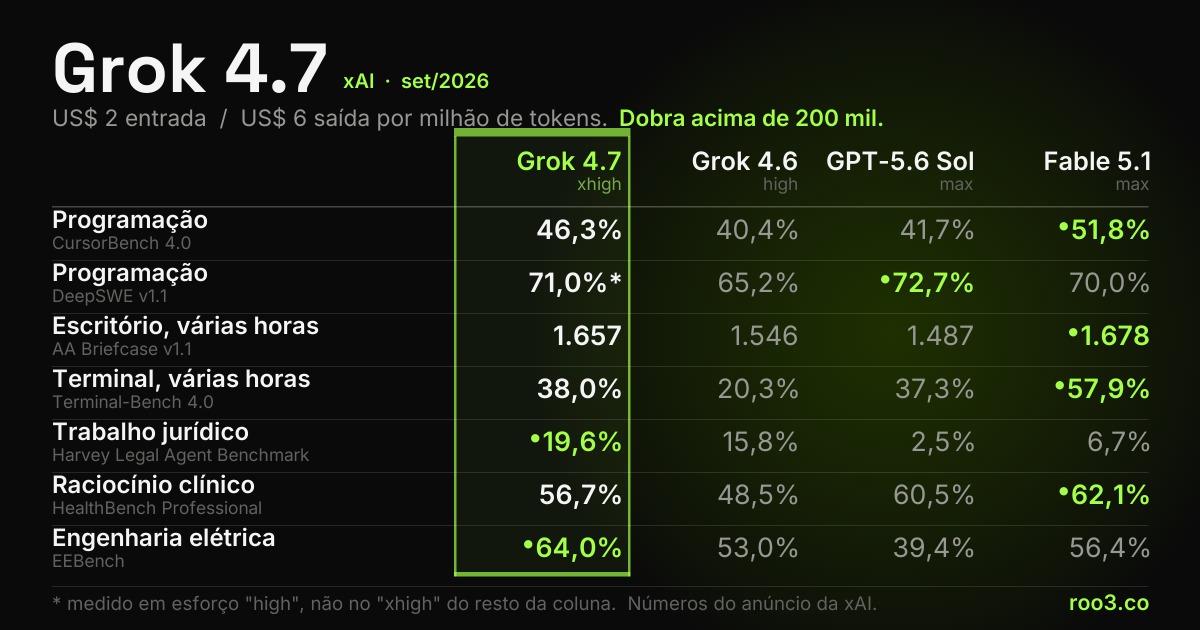
Grok 4.7: o mais barato da mesa ganha em dois testes de sete
Os benchmarks oficiais do Grok 4.7 contra GPT-5.6 Sol e Claude Fable 5.1, o preço por token, a letra miúda que dobra...
8 min de leitura
Qual a melhor IA hoje: como comparar sem seguir opinião
Como comparar modelos de IA usando medição pública em vez de opinião: o que é o ECI da Epoch AI, o que é o ELO da Arena...
9 min de leitura
Token e janela de contexto: por que a conta da IA vem alta
O que é token, o que é janela de contexto e como a cobrança funciona de verdade. Com a conta feita e os quatro erros...
11 min de leituraQuer aplicar isso na sua empresa?
A ROO3 faz o diagnóstico do que dá para automatizar primeiro no seu negócio. A conversa inicial é gratuita.