Grok 4.7 chegou: ganha em dois dos sete testes, e é cinco vezes mais barato que quem ganha nos outros
A xAI publicou a comparação com GPT-5.6 e Claude Fable 5.1. O número que decide não está destacado na tabela: é o que acontece com o preço quando o texto passa de 200 mil tokens.

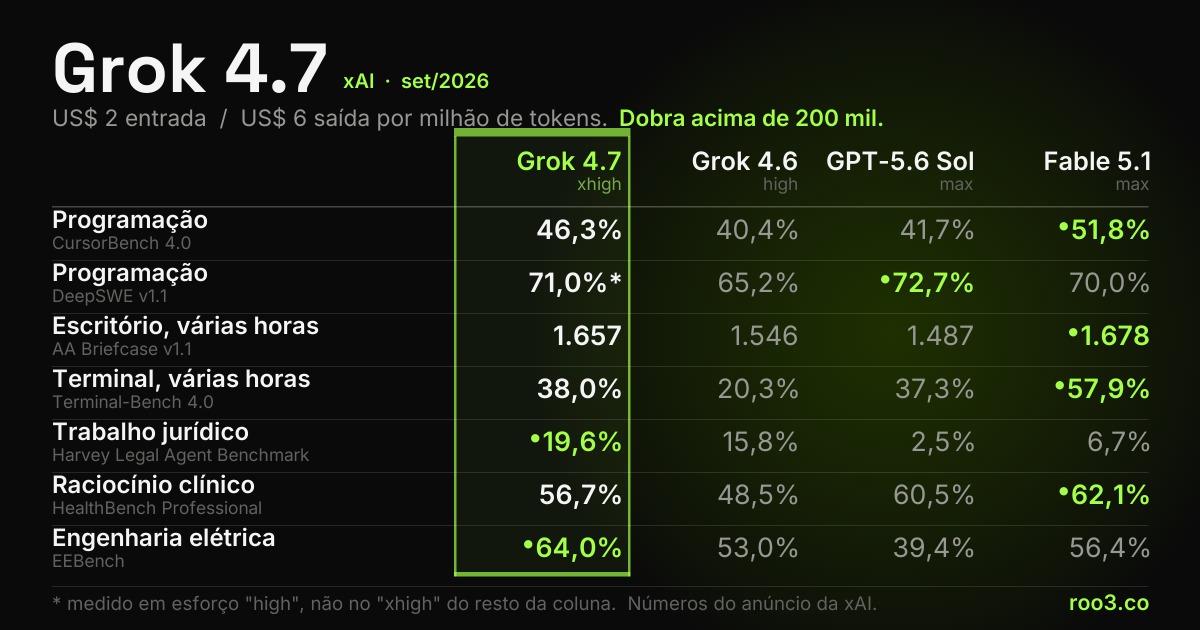
O Grok 4.7 entrou no catálogo da xAI em setembro de 2026, custando US$ 2 por milhão de tokens de entrada e US$ 6 de saída, o mesmo preço do 4.6 e uma fração do que cobram os concorrentes diretos. Na comparação oficial publicada pela própria xAI, contra o GPT-5.6 Sol e o Claude Fable 5.1, ele vence em dois dos sete testes: trabalho jurídico e engenharia elétrica. Perde nos quatro que medem programação e trabalho autônomo longo. O detalhe que a tabela não mostra é que o preço dobra quando a conversa passa de 200 mil tokens, e que um dos números da coluna dele foi medido num ajuste de esforço diferente do resto.
O que você leva deste artigo
- O modelo já está no catálogo oficial da xAI como grok-4.7, marcado como o mais capaz da casa.
- Preço: US$ 2 por milhão de entrada e US$ 6 de saída, até 200 mil tokens.
- Acima de 200 mil tokens o preço DOBRA: US$ 4 de entrada e US$ 12 de saída. Isso não aparece na tabela de lançamento.
- Vence em 2 de 7 testes: Harvey, de trabalho jurídico, e EEBench, de engenharia elétrica.
- Perde em 4 de 7 para o Claude Fable 5.1, com a maior diferença em trabalho de terminal: 38,0% contra 57,9%.
- O 71,0% em DeepSWE tem asterisco: foi medido em esforço "high", não no "xhigh" do resto da coluna.
- O próprio Musk classificou o modelo como "mais ou menos no nível do Opus 5.0, não do 5.1".
O que saiu, e como confirmar sem depender de print
O Grok 4.7 passou semanas sendo anunciado antes de existir. Em 2 de setembro de 2026 Elon Musk disse que sairia em dez dias. A data passou, e ele escreveu que o modelo precisava de "mais alguns dias no forno". Em 18 de setembro ainda não havia lançamento, nem identificador na documentação da xAI.
Agora existe. A forma de confirmar isso não é a captura de tela que circula no X, e sim a documentação da própria xAI: o identificador grok-4.7 está no catálogo de modelos, marcado como o mais capaz da casa e recomendado para código e conversa. É esse o teste que vale, porque print de tabela qualquer um monta.
Junto com o modelo veio a comparação oficial contra o GPT-5.6 Sol, da OpenAI, e o Claude Fable 5.1, da Anthropic. É ela que está reproduzida abaixo, com os números conferidos contra o anúncio.
A tabela, com os sete testes
Antes de olhar: cada modelo foi medido num ajuste de esforço diferente, e isso está declarado logo abaixo do nome de cada coluna. Esforço, nesses modelos, é quanto o sistema pensa antes de responder, e mexe tanto no resultado quanto no custo.
| Grok 4.7 xhigh | Grok 4.6 high | GPT-5.6 Sol max | Fable 5.1 max | |
|---|---|---|---|---|
| Preço de entrada US$ por milhão de tokens | US$ 2 | US$ 2 | US$ 4 | US$ 10 |
| Preço de saída US$ por milhão de tokens | US$ 6 | US$ 6 | US$ 20 | US$ 50 |
| Programação CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| Programação DeepSWE v1.1 | 71,0%* | 65,2% | 72,7% | 70,0% |
| Trabalho de escritório longo AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Trabalho de terminal longo Terminal-Bench 4.0 | 38,0% | 20,3% | 37,3% | 57,9% |
| Trabalho jurídico Harvey Legal Agent Benchmark | 19,6% | 15,8% | 2,5% | 6,7% |
| Raciocínio clínico HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
| Engenharia elétrica EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
Onde ele ganha, e o que os dois testes têm em comum
As duas vitórias do Grok 4.7 não são em programação. São em conhecimento de domínio.
No Harvey, que mede trabalho jurídico de verdade, ele faz 19,6%. O Fable 5.1 faz 6,7% e o GPT-5.6 faz 2,5%. É quase três vezes o segundo colocado, e essa não é uma vantagem nova: o Grok 4.6 já fazia 15,8% nesse mesmo teste, também bem à frente dos outros.
No EEBench, de engenharia elétrica, são 64,0% contra 56,4% do Fable e 39,4% do GPT-5.6. Aqui o salto interno chama atenção: o 4.6 fazia 53,0%.
Vale registrar o que os números absolutos dizem, e não só quem ganhou. 19,6% de acerto em trabalho jurídico é pouco, em termos absolutos. O teste é difícil de propósito, e ninguém está perto de resolvê-lo. Ler "o Grok ganha em jurídico" como "dá para usar o Grok no lugar de um advogado" é o tipo de conclusão que a tabela não autoriza.
Ganhar num teste em que todo mundo vai mal não é o mesmo que ser bom naquilo. Diz quem está menos longe, não quem chegou.
Onde ele perde, e é onde mais gente usa
Das sete linhas, o Claude Fable 5.1 vence quatro, e são justamente as ligadas a programar e a executar tarefas longas sozinho.
A diferença mais dura está no Terminal-Bench 4.0, que mede trabalho longo dentro do terminal: 38,0% do Grok contra 57,9% do Fable. São quase vinte pontos.
Em compensação, é também onde o Grok 4.7 mais evoluiu em relação ao antecessor. O 4.6 fazia 20,3% nesse teste. Saltar para 38,0% é um avanço de 87% sobre a geração anterior, o maior de toda a tabela. O modelo melhorou muito no que era o ponto mais fraco dele, e continua atrás.
Em CursorBench 4.0 são 46,3% contra 51,8% do Fable. Em AA Briefcase, que mede trabalho de escritório de várias horas, 1.657 contra 1.678, praticamente empate. Em raciocínio clínico, 56,7% contra 62,1%.
Existe um detalhe de leitura sobre o CursorBench que vale carregar. Quando o Grok 4.5 saiu, a própria Cursor registrou que uma cópia antiga do código dela tinha entrado sem querer no treinamento do modelo, o que dava vantagem naquele teste específico. Foi com o 4.5, não com o 4.7, e não há indicação de que se repita. Mas é um bom lembrete de que benchmark é feito de dados, e dado vaza.
O preço, e a linha que a tabela de lançamento não mostra
Aqui está a informação mais útil do texto inteiro, e ela não estava na imagem que circulou.
Os US$ 2 de entrada e US$ 6 de saída valem até 200 mil tokens. Passando disso, a documentação da xAI mostra o preço dobrando: US$ 4 e US$ 12. Quem for usar o modelo para ler contrato inteiro, base de código grande ou histórico longo de conversa vai cair nessa faixa sem perceber, porque a conta é por requisição e ninguém fica somando token na cabeça.
Ainda assim, mesmo dobrado, ele continua o mais barato da mesa. Na saída, que é onde o dinheiro realmente vai embora, o Fable 5.1 custa US$ 50 por milhão contra US$ 6 do Grok. São oito vezes e pouco. O GPT-5.6 Sol custa US$ 20, mais de três vezes.
Então a pergunta prática não é "qual é o melhor". É: os vinte pontos de diferença no Terminal-Bench valem pagar oito vezes mais na saída? Para escrever e-mail, resumir reunião e responder cliente, quase certamente não. Para um agente que roda sozinho por horas mexendo no seu código, quase certamente sim, porque ali o erro custa mais caro que o token.
Preço de tabela é sobre o modelo. Preço real é sobre a tarefa. Um modelo oito vezes mais caro que acerta na primeira pode sair mais barato que um barato que precisa de três tentativas.
Como ler benchmark de fabricante sem se enganar
Esta tabela foi publicada pela xAI, sobre o modelo da xAI. Isso não a torna falsa, e os números batem com o que a própria empresa divulgou. Mas muda a forma de ler, e três coisas merecem atenção.
Primeira: cada coluna está num esforço diferente. O Grok 4.7 aparece em "xhigh", o 4.6 em "high", os concorrentes em "max". Não é comparação de igual para igual, é cada um no ajuste que a casa escolheu mostrar.
Segunda: tem asterisco no meio da coluna. O 71,0% em DeepSWE foi medido em "high", não no "xhigh" das outras linhas. É uma nota honesta, e está lá. Mas significa que aquela linha não é comparável com as vizinhas da mesma coluna.
Terceira: quem escolhe os testes é quem publica. Sete testes foram mostrados. Não há como saber quantos foram rodados. Isso vale para toda tabela de lançamento, de qualquer empresa, e é o motivo de conferir em avaliação independente antes de decidir.
Há uma quarta fonte, e é a menos suspeita de todas, porque joga contra. Em 14 de setembro, antes do lançamento, o próprio Musk classificou o modelo como "mais ou menos no nível do Opus 5.0, não do 5.1. Melhor em algumas coisas, pior em outras". É exatamente o que a tabela mostra.
O que muda para quem usa IA no trabalho
Quase nada muda esta semana, e essa é a resposta honesta. O que muda é a conta de quem paga por token e roda volume.
Se você usa IA pela interface, num plano mensal, nada disso te afeta: você não escolhe modelo por preço de token. Se você construiu alguma coisa que chama a API, aí a tabela tem consequência direta, e ela cabe em quatro decisões.
- Tarefa de volume e baixo risco, como classificar mensagem, resumir e extrair dado: o mais barato resolve, e a diferença de qualidade não aparece.
- Agente que executa sozinho por muito tempo, mexendo em código ou em sistema: pague pelo melhor. O erro custa mais que o token.
- Se o seu texto passa de 200 mil tokens com frequência, refaça a conta com o preço dobrado, não com o de tabela.
- Antes de trocar de modelo por causa de benchmark, rode a SUA tarefa nos dois. Vinte pontos num teste padronizado podem virar zero no seu caso, ou o contrário.
Perguntas frequentes
O Grok 4.7 é melhor que o Claude e que o GPT?
Depende do que você vai fazer. Na comparação publicada pela xAI, o Grok 4.7 vence em dois dos sete testes, os de trabalho jurídico e engenharia elétrica. O Claude Fable 5.1 vence em quatro, incluindo os dois de programação e o de trabalho longo em terminal. O GPT-5.6 Sol vence em um. O Grok é, com folga, o mais barato dos três.
Quanto custa o Grok 4.7?
US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de saída, para contexto de até 200 mil tokens. Acima disso o preço dobra, para US$ 4 e US$ 12. Para comparar: o GPT-5.6 Sol cobra US$ 4 e US$ 20, e o Claude Fable 5.1 cobra US$ 10 e US$ 50.
O que significa o asterisco no 71% do DeepSWE?
Significa que aquele número foi medido num ajuste de esforço diferente do resto da coluna: "high" em vez de "xhigh". Esforço é quanto o modelo pensa antes de responder, e afeta resultado e custo. Na prática, aquela linha não é diretamente comparável com as outras da mesma coluna.
Como sei se o Grok 4.7 realmente foi lançado?
Olhando a documentação da xAI, não uma captura de tela. O identificador grok-4.7 está no catálogo oficial de modelos, com preço publicado. Esse foi o teste que faltava durante as semanas em que o lançamento foi anunciado e adiado várias vezes.
Vale a pena trocar de modelo por causa desses números?
Só depois de testar com a sua própria tarefa. Benchmark mede um conjunto específico de problemas, e a diferença que aparece lá pode sumir no seu caso, ou aumentar. O caminho barato é rodar as mesmas dez tarefas reais nos dois modelos e comparar resultado e custo antes de mudar qualquer coisa em produção.
Dá para confiar em benchmark publicado pelo próprio fabricante?
Dá para usar como ponto de partida, desde que se leia o rodapé. Nesta tabela, cada modelo foi medido num ajuste de esforço diferente, um dos números tem nota explicando que foi medido em outro ajuste, e quem escolheu quais sete testes mostrar foi quem publica. Nada disso torna os números falsos, mas torna a comparação menos direta do que parece.
Rodrigo Fávaro
Fundador da ROO3, agência de marketing e tecnologia em São José do Rio Preto. Constrói produtos com IA em produção (Tobia, gerar.app, Pense Mercado) e mantém o AI Benchmark, ranking público de modelos de IA. Veja a consultoria em IA da ROO3.
X @rodmf LinkedIn rodrigofavaroContinue lendo
O que é o Grok, a IA da SpaceXAI, e onde ele se diferencia
O que é o Grok, a IA hoje da SpaceXAI: como usa dados do X em tempo real, onde leva vantagem, onde atrapalha e quando...
9 min de leitura
Qual a melhor IA hoje: como comparar sem seguir opinião
Como comparar modelos de IA usando medição pública em vez de opinião: o que é o ECI da Epoch AI, o que é o ELO da Arena...
9 min de leitura
Token e janela de contexto: por que a conta da IA vem alta
O que é token, o que é janela de contexto e como a cobrança funciona de verdade. Com a conta feita e os quatro erros...
11 min de leituraQuer aplicar isso na sua empresa?
A ROO3 faz o diagnóstico do que dá para automatizar primeiro no seu negócio. A conversa inicial é gratuita.