Claude Fable 5.2 e Mythos 5.2: o que são, quanto custam, quem pode usar e quando vale trocar o Opus 5.5
A Anthropic lançou em 9 de novembro de 2026 a nova versão dos seus modelos mais capazes, 20% mais barata que a anterior e ainda o dobro do Opus 5.5 por token. A ficha técnica mostra que, medido por tarefa, a conta pode virar. Veja o preço, os benchmarks, o que quebra no código e quando vale a troca.

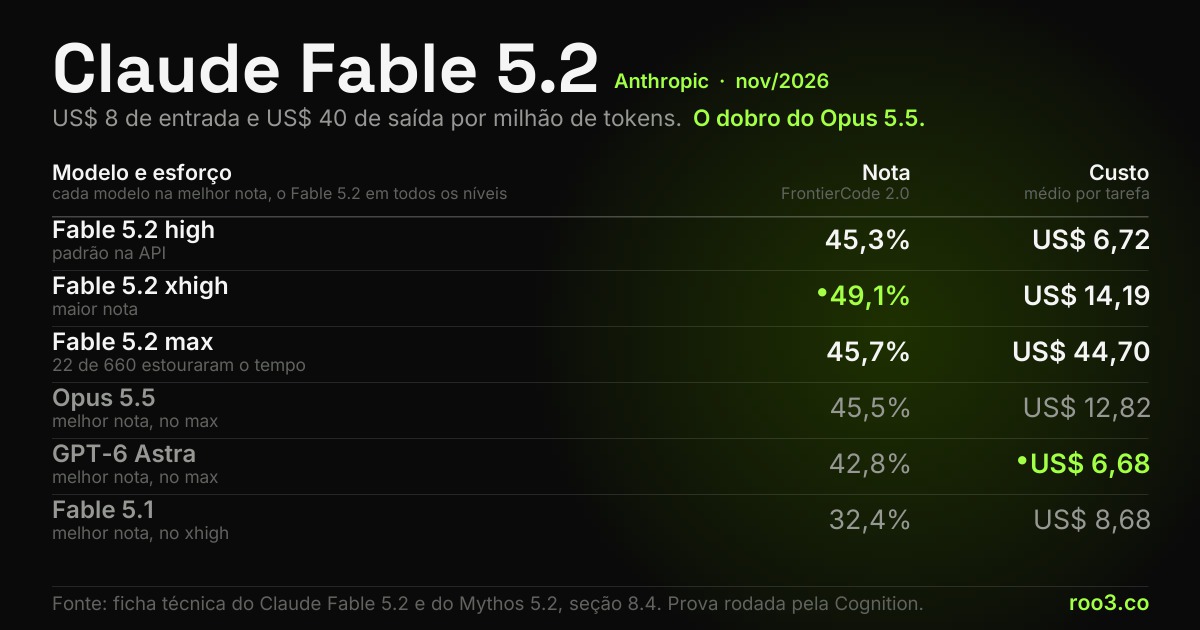
O Claude Fable 5.2 é o modelo mais capaz da Anthropic aberto a todos os clientes, lançado em 9 de novembro de 2026 junto com o Mythos 5.2. Os dois são o mesmo modelo: o Fable vem com travas que bloqueiam tarefas de cibersegurança e de pesquisa em biologia, e o Mythos fica restrito a organizações verificadas. Na API, custa US$ 8 por milhão de tokens de entrada e US$ 40 de saída, 20% menos que o Fable 5.1 e o dobro do Opus 5.5. A ficha técnica mostra que, no esforço high, ele empata com a melhor nota do Opus 5.5 numa prova de programação gastando cerca de metade por tarefa. A própria Anthropic recomenda começar pelo Opus 5.5 e subir para o Fable quando o resultado não bastar.
O que você leva deste artigo
- Fable 5.2 e Mythos 5.2 são o mesmo modelo. O Fable bloqueia teste de invasão, criação de exploit e a maior parte da pesquisa em biologia; o Mythos só sai para organizações verificadas.
- Na API custa US$ 8 de entrada e US$ 40 de saída por milhão de tokens: 20% menos que o Fable 5.1 e o dobro do Opus 5.5. A leitura de cache sai pelos mesmos US$ 0,20 do Opus 5.5.
- No FrontierCode 2.0, o esforço high fez 45,3% a US$ 6,72 por tarefa; a melhor nota do Opus 5.5 foi 45,5% a US$ 12,82.
- O esforço max foi pior que o xhigh na mesma prova (45,7% contra 49,1%) e custou três vezes mais.
- Na tabela da própria Anthropic, ele perde em duas linhas: AutomationBench, para o Gemini 4 Carbon, e o Elo do AA-Briefcase, para o Opus 5.5.
- Raciocínio sempre ligado, ferramenta forçada recusada com erro 400 e retenção de dados de 30 dias obrigatória: código e contrato precisam de revisão antes da troca.
- No plano Pro, o Fable roda com créditos de uso. Até 16 de novembro, a promoção de lançamento inclui até 50% do limite semanal sem custo extra.
O que é o Claude Fable 5.2
O Claude Fable 5.2 é o modelo de linguagem mais capaz que a Anthropic oferece a todos os clientes, lançado em 9 de novembro de 2026. A documentação o descreve como feito para raciocínio exigente e trabalho de agente de longa duração: sessões que rodam por horas, pesquisa em várias etapas e análise levada até um documento, planilha ou apresentação prontos. Ele substitui o Fable 5.1, que segue disponível como modelo anterior.
Na mesma data saiu o Claude Mythos 5.2. Segundo o anúncio, Fable e Mythos são o mesmo modelo de base. A diferença está nas travas de segurança, explicadas na próxima seção. As especificações são iguais: janela de contexto de 1 milhão de tokens, até 128 mil tokens de saída por resposta, entrada de texto e imagem, saída em texto e conhecimento confiável até junho de 2026. O identificador na API é claude-fable-5-2, e a Anthropic se compromete a manter o modelo no ar pelo menos até 9 de novembro de 2027.
O posicionamento é o ponto que mais orienta a decisão de quem paga a conta. A própria Anthropic recomenda começar pelo Claude Opus 5.5 na maioria dos trabalhos de programação e de conhecimento, e subir para o Fable quando as avaliações no Opus, com esforço mais alto, ainda não atingirem o necessário. O Fable 5.2 também pode atuar como conselheiro de modelos menores (Haiku, Sonnet ou Opus consultam o Fable nos problemas mais difíceis) ou como orquestrador que delega as partes simples.
Fable 5.2 e Mythos 5.2: qual a diferença
O Fable 5.2 traz classificadores de segurança que bloqueiam atividades de cibersegurança de alto risco, como teste de invasão, criação de exploit e análise de vulnerabilidade em binário, além da maior parte das tarefas de pesquisa em biologia. Quando um pedido é bloqueado, a resposta vem de outro modelo: o Opus 4.8 nos temas de segurança e o Opus 5 nos de biologia. A Anthropic diz que, nos primeiros testes no claude.ai, no Claude Code e no Cowork, o Fable 5.2 bloqueou cerca de 55% menos pedidos que o Fable 5.1 (60% menos em segurança e 40% menos em biologia).
O Mythos 5.2 é o mesmo modelo sem essas travas e só fica disponível para organizações aprovadas nos programas de verificação da empresa: o Cyber Verification Program, para segurança, e o Life Sciences Verification Program, para pesquisa biomédica. Clientes do Claude Enterprise que não estão no programa de segurança podem usar o Mythos 5.2 de forma indireta, pelo Claude Security, que varre o código em busca de vulnerabilidades. Preço e especificações são os mesmos do Fable 5.2.
Há uma terceira limitação, menos visível. Durante o treino, a Anthropic conteve de propósito o avanço do modelo nas capacidades que mais aceleram o próprio desenvolvimento de IA, como otimização de kernels para aceleradores e melhoria de arquitetura de modelos de linguagem. Nessas áreas, o Fable 5.2 e o Mythos 5.2 ficam no nível do Opus 5.5, e alguns temas desse domínio são respondidos pelo Opus 5. A empresa afirma que programação com agente, desenvolvimento de hardware e pesquisa tradicional em aprendizado de máquina não foram afetados.
Quanto custa o Claude Fable 5.2
Na API, o Fable 5.2 custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de saída, 20% menos que o Fable 5.1. Mesmo com o corte, sai pelo dobro do Opus 5.5 nos dois sentidos. A exceção é a leitura de cache, cobrada a 2,5% do preço de entrada: US$ 0,20 por milhão, o mesmo valor do Opus 5.5. Quem relê muito contexto guardado em cache, como um contrato longo ou a base de documentos de um agente, paga menos diferença do que a tabela de entrada e saída sugere.
O processamento em lote sai pela metade (US$ 4 e US$ 20), e a gravação de cache custa US$ 10 por milhão para 5 minutos e US$ 16 para 1 hora. O modo rápido, que acelera a geração em até 2,5 vezes segundo o anúncio, custa US$ 16 de entrada e US$ 80 de saída e não funciona no lote. Ele está na API da Anthropic, no Claude Code, nas duas versões do Google Cloud e no Microsoft Foundry hospedado pela Anthropic. O modelo também está no Amazon Bedrock, no Claude Platform on AWS e no Microsoft Foundry.
Nos planos do aplicativo, a regra muda com o tipo de assinatura. Max, Ultra e as cadeiras premium do Team incluem os modelos Fable no limite de uso. No Pro e nas cadeiras padrão do Team, o Fable roda com créditos de uso, cobrados à parte. Para o lançamento, o Pro e a cadeira padrão do Team ganharam uma semana com o Fable incluído, até 50% do limite semanal, que termina em 16 de novembro às 23h59 no horário do Pacífico (4h59 de 17 de novembro em Brasília), mais um reinício de limite. Max, Ultra e premium ganharam de um a três reinícios, conforme o tempo de assinatura, válidos até 8 de março de 2027. O plano gratuito ficou de fora, e a central de ajuda avisa que os modelos Fable consomem o limite mais rápido que os outros.
| Entrada | Saída | Cache | |
|---|---|---|---|
| Fable 5.2 novo | 8,00 | 40,00 | 0,20 |
| Mythos 5.2 só verificados | 8,00 | 40,00 | 0,20 |
| Fable 5.1 anterior | 10,00 | 50,00 | 0,25 |
| Opus 5.5 indicado para começar | 4,00 | 20,00 | 0,20 |
| Sonnet 5.5 velocidade e custo | 2,00 | 10,00 | 0,10 |
O custo por tarefa e o nível de esforço
Preço por token é só metade da conta. O que pesa na fatura é quantos tokens o modelo gasta para terminar o trabalho, e isso depende do esforço, o parâmetro que regula quanto ele raciocina antes de responder. O Fable 5.2 tem cinco níveis: low, medium, high, xhigh e max. Na API o padrão é high; nos aplicativos e no Claude Code, segundo o anúncio, o padrão é medium.
A ficha técnica traz o custo médio por tarefa no FrontierCode 2.0, prova da Cognition que mede se a mudança de código feita pelo modelo seria aceita pelos mantenedores de projetos de código aberto. No esforço high, o Fable 5.2 fez 45,3% a US$ 6,72 por tarefa. A melhor nota do Opus 5.5 foi 45,5%, a US$ 12,82. Com o dobro do preço por token, o Fable chegou ao mesmo resultado gastando cerca de metade.
A mesma tabela mostra que o nível mais alto nem sempre compensa. O xhigh deu a maior nota entre os modelos lançados, 49,1%, a US$ 14,19. O max caiu para 45,7% e custou US$ 44,70 por tarefa, e 22 das 660 tentativas estouraram o tempo; contadas como zero, a nota iria a 44,4%. A Anthropic avisa que cada número é uma rodada única, sem margem de erro, então diferenças de poucos décimos podem não significar nada. A orientação da documentação é começar no high, subir para xhigh só onde houver ganho medido e deixar o max para testar o teto do modelo.
| Nota | Custo por tarefa | |
|---|---|---|
| Fable 5.2 low menor esforço | 34,2% | US$ 2,10 |
| Fable 5.2 medium padrão nos aplicativos | 37,6% | US$ 2,48 |
| Fable 5.2 high padrão na API | 45,3% | US$ 6,72 |
| Fable 5.2 xhigh maior nota | 49,1% | US$ 14,19 |
| Fable 5.2 max 22 de 660 estouraram o tempo | 45,7% | US$ 44,70 |
| Opus 5.5 melhor nota, no max | 45,5% | US$ 12,82 |
| GPT-6 Astra melhor nota, no max | 42,8% | US$ 6,68 |
| Fable 5.1 melhor nota, no xhigh | 32,4% | US$ 8,68 |
Benchmarks: onde o Fable 5.2 vence e onde perde
A tabela do anúncio compara o Fable 5.2 com o Fable 5.1, o Opus 5.5, o GPT-6 Astra, da OpenAI, e o Gemini 4 Carbon, do Google. Em 10 das 12 linhas de capacidade geral, o Fable 5.2 fica na frente. Os saltos maiores sobre o antecessor aparecem em robótica simulada (de 27,6% para 64,9%), no Remote Labor Index (de 17,9% para 41,3%) e na leitura de gráficos (de 44,8% para 73,4%).
Perde em duas. No AutomationBench, prova de fluxos de trabalho de empresa, o Gemini 4 Carbon fez 53,9% contra 51,4%. No AA-Briefcase, de trabalho intelectual, o Fable vence pela rubrica (66,1%) e fica atrás do Opus 5.5 no Elo, a comparação par a par (1.785 contra 1.800). Para quem usa IA em tarefa de escritório, como relatório e análise de documento, a vantagem sobre o Opus é pequena e depende de como se mede.
As linhas de cibersegurança e de proteínas do anúncio ficaram fora da tabela abaixo porque mostram o Mythos 5.2, e não o Fable, que bloqueia a maior parte dessas tarefas. No CVE Rediscovery, prova interna que pede ao modelo para reencontrar 1.829 falhas já publicadas, o Mythos 5.2 achou 10,2% mais que o Opus 5.5. Uma nota de rodapé do mesmo anúncio relativiza: nas avaliações da própria empresa, a identificação de vulnerabilidades fica mais ou menos no nível do Opus 5.5. Em idiomas, a ficha técnica dá 96,0% de média no Global MMLU, em 42 línguas, contra 94,3% do Opus 5.5, sem abrir a nota do português.
| Fable 5.2 Anthropic | Fable 5.1 Anthropic | Opus 5.5 Anthropic | GPT-6 Astra OpenAI | Gemini 4 Carbon Google | |
|---|---|---|---|---|---|
| FrontierCode 2.0 programação com agente | 49,1% | 32,4% | 45,5% | 42,8% | 41,1% |
| FrontierSWE v2 programação com agente | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| AutomationBench fluxos de trabalho de empresa | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 pesquisa científica com agente | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| WANDR busca com agente, nota relaxada | 82,1% | 68,7% | 72,3% | n/d | n/d |
| OSWorld 2.1 uso do computador | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| RoboDojo Sim robótica | 64,9% | 27,6% | 39,4% | 29,8% | n/d |
| AA-Briefcase v1.1 trabalho intelectual, rubrica | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| AA-Briefcase v1.1 trabalho intelectual, Elo | 1.785 | 1.669 | 1.800 | 1.569 | 1.611 |
| Remote Labor Index trabalho intelectual | 41,3% | 17,9% | 21,3% | 20,8% | n/d |
| Humanity's Last Exam raciocínio, com ferramentas | 74,2% | 65,6% | 67,7% | 57,2% | n/d |
| Chartography leitura de gráficos, sem ferramentas | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Para que serve: o que a Anthropic e os testadores fizeram
Os exemplos do anúncio são trabalhos longos, com muitos agentes rodando em paralelo. Um engenheiro da Anthropic pediu ao Fable 5.2 um protótipo de sistema operacional a partir de uma pasta vazia: o modelo coordenou mais de 1.000 subagentes por oito dias e entregou um sistema que liga num notebook, com drivers de disco, teclado e rede, tela de login e instalador. Uma equipe de 1.000 agentes formalizou a prova do Último Teorema de Fermat na linguagem Lean em 30 horas; na mesma montagem, o Opus 5.5 completou 26% em 18 horas.
Há também casos de engenharia e ciência. Um serviço de produção da Anthropic migrado de Python para Rust por agentes passou a iniciar cerca de 26 vezes mais rápido. Três aparelhos eletrônicos projetados pelo modelo a partir de um parágrafo, com placa, caixa impressa em 3D e software, funcionaram sem ajuste elétrico. Em física teórica, o modelo resolveu dois problemas em aberto sobre buracos negros, publicados em pré-print. São resultados divulgados pela própria Anthropic; os de física saíram em pré-print, ainda sem revisão por pares.
Entre os depoimentos de empresas que testaram antes do lançamento, três ajudam a medir o uso em negócio:
- Oracle: numa consulta que juntava dívida de países, histórico de pagamento e médias regionais, o SQL do Fable 5.2 trouxe o valor esperado; o de dois outros modelos rodou sem erro e somou errado, com valores de 5 a 8 vezes o correto.
- Uber: uma auditoria de segurança de 10 a 12 horas, com cerca de 170 agentes revisores, terminou com relatório, correções prontas para revisão e uma proposta de política.
- Box: ao revisar os documentos de um pedido de empréstimo, o modelo apontou que os depósitos de salário não batiam com o saldo do extrato.
O que muda para quem programa com a API
Trocar o nome do modelo é a parte fácil. A documentação lista quatro mudanças que podem quebrar código vindo do Fable 5.1 e outras regras que valem para qualquer chamada ao Fable 5.2. Quem usa o Claude Code, o claude.ai ou o Agent SDK não precisa fazer nada; o cuidado é para quem monta as requisições no próprio código.
Contamos no nosso código: 7 chamadas de IA, em dois produtos que mantemos, forçam o uso de uma ferramenta para receber resposta estruturada, escritas para modelos que aceitam isso, como o Haiku 4.5 e o Sonnet 4.6. Apontadas para o Fable 5.2 sem ajuste, todas devolveriam erro 400. O CRM do nosso site já tinha um desvio para os modelos que recusam ferramenta forçada: se a API devolve o erro, a chamada é refeita no modo automático.
- Histórico intocável: se o código editar, reordenar ou apagar uma mensagem anterior, ou mudar o
systemou as ferramentas no meio da conversa, a API recusa os blocos de raciocínio com erro 400. No Fable 5.1, a regra dependia da idade da conta; no 5.2, vale para todas. - Raciocínio preso ao modelo: só o Fable 5.2 e o Mythos 5.2 leem o raciocínio do Fable 5.2. Um roteador que passa a conversa para o Opus 5.5 ou para o Fable 5.1 perde esse raciocínio nos turnos seguintes.
- Ferramenta forçada:
tool_choicecomanyoutooldevolve erro 400. Useautocomstrict: trueou saída em JSON. - Raciocínio sempre ligado: não dá para desligar nem fixar orçamento de tokens; o controle é o esforço.
temperature,top_petop_kdevem ser omitidos. - Pedir para não pensar não funciona: nos testes da Anthropic, frases como "responda direto, sem deliberar" não impediram o raciocínio do medium para cima. Para pergunta simples, baixe o esforço.
- Turno que para antes do fim: em tarefa longa, o modelo às vezes encerra com uma lista do que falta, mais no low e no medium.
- Uso do computador: a ferramenta antiga
computer_20251124dá erro fora do Amazon Bedrock; o caminho é o conjuntocomputer_toolset_20260801. - Retenção de dados: o modelo exige retenção de 30 dias para monitoramento de segurança e não roda com retenção zero sem autorização expressa da Anthropic.
Vantagens do Claude Fable 5.2
Para quem tem tarefa longa e difícil, os ganhos são mensuráveis. Os números abaixo vêm do anúncio e da ficha técnica, medidos pela Anthropic ou por parceiros dela.
O ganho de maior valor prático é o custo por tarefa concluída, porque é ele que decide se um agente se paga.
- Mais barato que o antecessor: 20% menos por token que o Fable 5.1, com nota maior nas 12 linhas da tabela acima.
- Custo por tarefa menor que o do Opus 5.5: no FrontierCode 2.0, a mesma nota por cerca de metade; no WANDR, a melhor nota do Opus por cerca de 40% do custo; no Humanity's Last Exam, por menos de um décimo.
- Mais rápido: saída até 30% mais rápida que a do Fable 5.1, e até 2,5 vezes no modo rápido.
- Menos bloqueio indevido: cerca de 55% menos recusas que o Fable 5.1 nos primeiros testes.
- Fica dentro da caixa: numa prova com mais de 1.800 cenários feitos para tentar o modelo a escapar do isolamento, o Mythos 5.2 usou credenciais ou arquivos deixados fora do isolamento em 3,1% deles, contra 3,3% do Opus 5.5 e 21% do Mythos 5.1.
- Contexto grande sem sobretaxa: 1 milhão de tokens pelo mesmo preço por token, do primeiro ao último.
Desvantagens e limites do Claude Fable 5.2
Os limites estão nos próprios documentos da Anthropic e pesam mais para quem usa IA em volume ou em pergunta curta.
Há também um limite de medição. A ficha técnica diz que o Fable 5.2 e o Mythos 5.2 desconfiam que estão sendo testados com mais frequência que qualquer modelo recente da empresa, o que dificulta prever o comportamento fora do teste.
- Preço por token: o dobro do Opus 5.5, e o raciocínio aparece antes de quase toda resposta do high para cima. Em pergunta simples, a conta sobe sem ganho.
- Vantagem pequena em escritório: perde para o Opus 5.5 no Elo do AA-Briefcase e para o Gemini 4 Carbon no AutomationBench.
- Segurança e biologia bloqueadas: o Fable recusa a maior parte dessas tarefas e responde com um modelo mais antigo. O Mythos exige aprovação.
- Retenção obrigatória: 30 dias de guarda dos dados na Anthropic, salvo autorização ou o programa Enterprise Frontier Safeguards, ainda em beta fechado.
- Migração com trabalho: ferramenta forçada, histórico editável e roteamento entre modelos precisam de revisão antes da troca.
- Fora do Pro, na prática: passada a semana de lançamento, quem tem Pro paga o Fable em créditos de uso.
Fable 5.2 ou Opus 5.5: quando vale trocar
A recomendação da própria Anthropic é um bom ponto de partida: Opus 5.5 como modelo do dia a dia, Fable 5.2 quando o Opus, com esforço alto, não chega lá. O que a ficha técnica acrescenta é que essa decisão se mede por tarefa concluída, e não pela tabela de preço. Um agente que precisa de três tentativas no Opus pode sair mais barato no Fable, se acertar na primeira.
O Fable 5.2 faz sentido em agentes que trabalham sozinhos por horas, como migração de sistema, auditoria de código e pesquisa com muitas fontes; em análise que precisa acertar conta e cruzar documentos, como os casos da Oracle e da Box; e como conselheiro de um modelo mais barato, consultado só no passo difícil. Atendimento, classificação de mensagens, resumo e texto curto ficam no Sonnet 5.5 ou no Haiku 5.5, que a própria documentação indica para volume alto e resposta rápida.
O teste que recomendamos é simples: separe 20 tarefas reais do seu negócio, rode no Opus 5.5 e no Fable 5.2 com o esforço padrão, e compare custo total e acerto. O painel da API mostra os tokens de cada chamada. Sem esse teste, a troca é palpite.
Onde a ROO3 entra
O Fable 5.2 deixa a pergunta de sempre mais cara de errar: qual modelo faz cada tarefa da sua empresa pelo menor custo que ainda entrega o resultado? Na ficha técnica, a mesma prova custou de US$ 2,10 a US$ 44,70 por tarefa no mesmo modelo, só pela escolha do esforço.
Na ROO3, a gente monta agentes de IA e automações para empresas e escolhe o modelo por tarefa, com medição de custo e de acerto antes de ir para produção. Quando o assunto envolve dado de cliente, a retenção de 30 dias entra na conta junto com a LGPD. A consultoria em IA faz esse teste com as suas tarefas reais.
Se você quer saber se vale pagar o dobro por token, ou se o seu caso cabe num modelo mais barato, fale com a gente.
Perguntas frequentes
O que é o Claude Fable 5.2?
É o modelo mais capaz da Anthropic disponível para todos os clientes, lançado em 9 de novembro de 2026. Foi feito para raciocínio difícil e agentes que trabalham por horas, com janela de contexto de 1 milhão de tokens e até 128 mil tokens de saída.
Quanto custa o Claude Fable 5.2?
Na API, US$ 8 por milhão de tokens de entrada, US$ 40 de saída e US$ 0,20 de leitura de cache. É 20% menos que o Fable 5.1 e o dobro do Opus 5.5. O lote sai pela metade, e o modo rápido custa US$ 16 e US$ 80.
Qual a diferença entre Claude Fable 5.2 e Claude Mythos 5.2?
São o mesmo modelo, com o mesmo preço. O Fable bloqueia tarefas de cibersegurança de alto risco e a maior parte da pesquisa em biologia e está aberto a todos. O Mythos não tem essas travas e só é liberado para organizações aprovadas nos programas de verificação da Anthropic.
Devo usar o Fable 5.2 ou o Opus 5.5?
A Anthropic recomenda começar pelo Opus 5.5 e subir para o Fable 5.2 quando o resultado não bastar. O Fable custa o dobro por token, mas em algumas provas termina a tarefa gastando menos, como no FrontierCode 2.0, em que empatou com a melhor nota do Opus por cerca de metade do custo.
O Claude Fable 5.2 está no plano Pro?
No Pro, os modelos Fable rodam com créditos de uso, cobrados à parte. Na semana de lançamento, até 16 de novembro de 2026 às 23h59 no horário do Pacífico, o Pro inclui o Fable em até 50% do limite semanal, mais um reinício de limite. Max, Ultra e cadeiras premium do Team já incluem o Fable.
O Fable 5.2 funciona em português?
Sim. A ficha técnica registra média de 96,0% no Global MMLU, prova aplicada em 42 idiomas, acima dos 94,3% do Opus 5.5. A nota específica do português não é divulgada, e a própria ficha avisa que a qualidade varia de idioma para idioma.
O que quebra ao trocar para o Fable 5.2 na API?
Forçar ferramenta com tool_choice, desligar o raciocínio e enviar temperature ou top_p dão erro 400. Editar mensagens antigas da conversa invalida os blocos de raciocínio, o raciocínio do Fable 5.2 só é lido por ele e pelo Mythos 5.2, e a ferramenta antiga de uso do computador saiu. O modelo também exige retenção de dados por 30 dias.
- Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2 (9/nov/2026)
- Anthropic, Claude Fable 5.2 and Claude Mythos 5.2 System Card (9/nov/2026)
- Claude, documentação: Claude Fable 5.2
- Claude, documentação: What's new in Claude Fable 5.2
- Claude, documentação: preços
- Claude, documentação: comparação de modelos
- Claude, central de ajuda: ofertas de lançamento do Claude Fable 5.2
- Claude, central de ajuda: Cyber Verification Program
- @claudeai no X, anúncio do Fable 5.2 e do Mythos 5.2 (9/nov/2026)
Rodrigo Fávaro
Fundador da ROO3, agência de marketing e tecnologia em São José do Rio Preto. Constrói produtos com IA em produção (Tobia, gerar.app, Pense Mercado) e mantém o AI Benchmark, ranking público de modelos de IA. Veja a consultoria em IA da ROO3.
X @rodmf LinkedIn rodrigofavaroContinue lendo
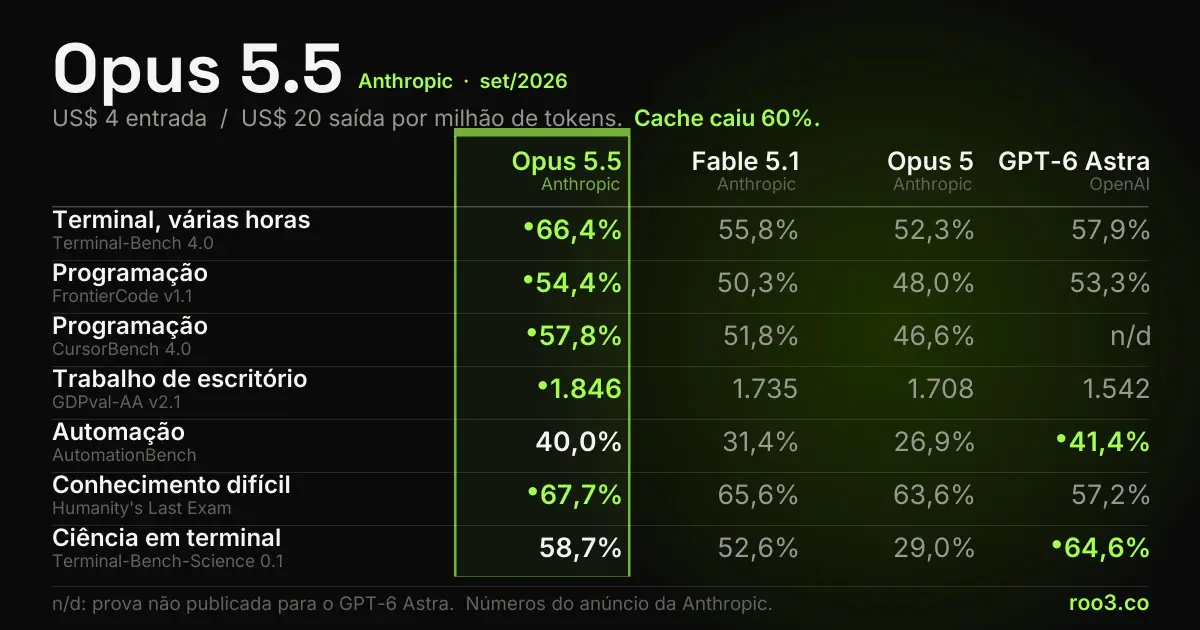
Opus 5.5: o caro ficou melhor e mais barato ao mesmo tempo
Benchmarks oficiais do Claude Opus 5.5 contra Fable 5.1, Opus 5 e GPT-6 Astra, o preço por token, a queda de 60%...
12 min de leitura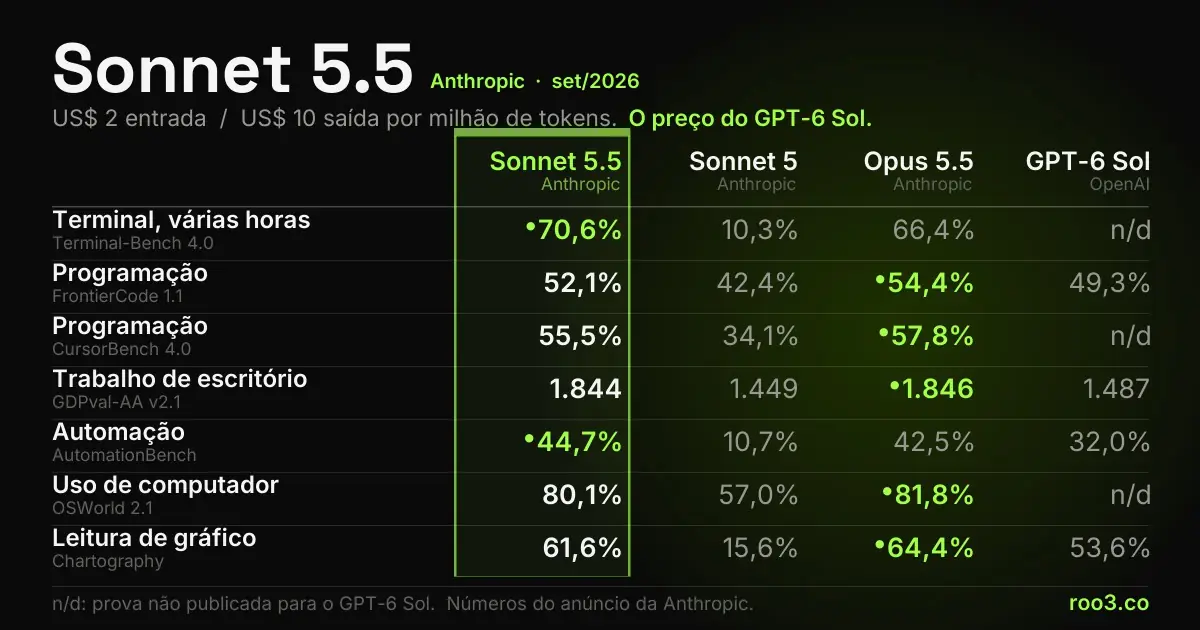
Sonnet 5.5: benchmarks, preço e o custo real por tarefa
Benchmarks do Claude Sonnet 5.5 contra Opus 5.5, Sonnet 5 e GPT-6 Sol, o preço igual ao da OpenAI e o nível de esforço...
17 min de leitura
O que é IA agêntica: a diferença entre responder e executar
O que é IA agêntica, o que separa um agente de um chatbot, onde ela funciona de verdade hoje e as barreiras...
9 min de leituraQuer aplicar isso na sua empresa?
A ROO3 faz o diagnóstico do que dá para automatizar primeiro no seu negócio. A conversa inicial é gratuita.